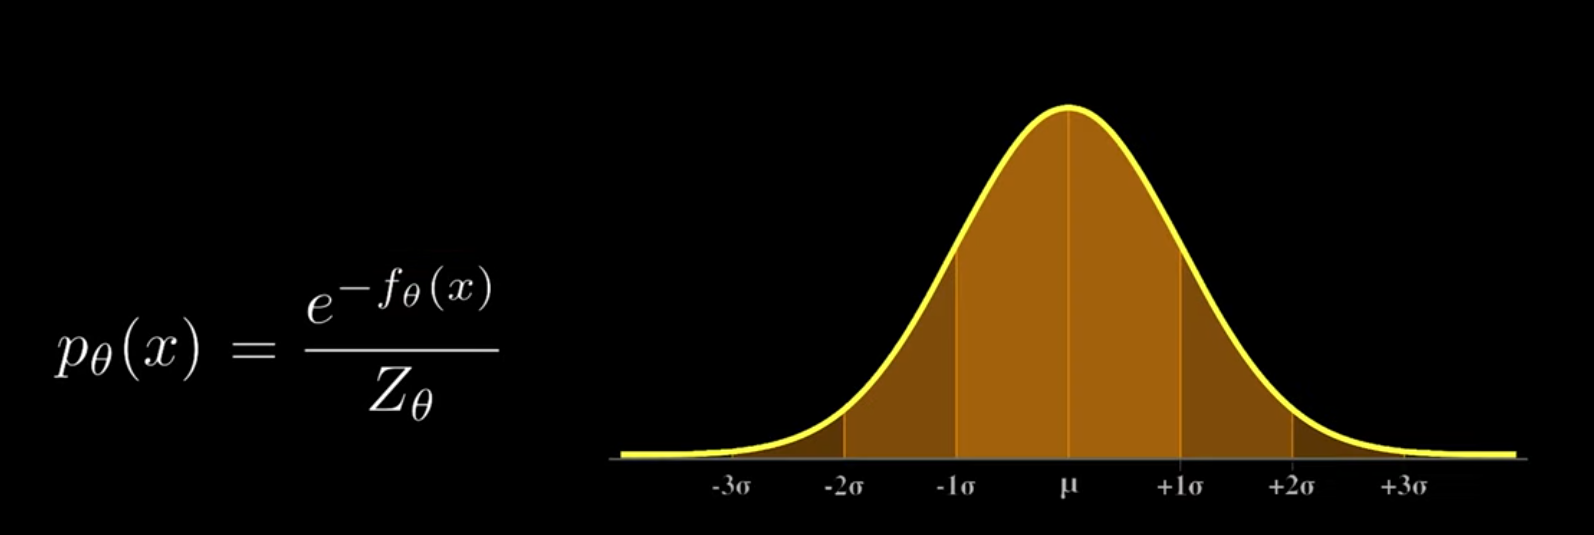
https://www.youtube.com/watch?v=wMmqCMwuM2Q
https://www.youtube.com/watch?v=B4oHJpEJBAA
https://scorebasedgenerativemodeling.github.io/
https://yang-song.net/blog/2021/score/
使用“基于得分的生成模型”这个术语,是希望强调它们与得分函数之间的关系。
得分函数被定义为对数概率密度的梯度。
统计学和机器学习中的典型假设是,训练数据中的所有数据点都来自某种潜在的数据分布。换句话说,这些数据点基本上是从该数据分布中独立抽取的样本,但我们并没有数据分布的解析形式,我们需要对其进行估计。
为了估计这个数据分布,我们需要创建一个模型。这个模型表示了一个参数化的概率分布,我们称之为模型分布。我们希望调整这个模型的参数,以确保它在某种意义上接近数据分布。
如果模型分布非常接近数据分布,那么我们可以将这个模型用于许多重要的应用。例如,当然,我们可以通过从这个模型分布中采样来生成无限数量的新的数据点。
另一个应用是,我们可以使用这个模型分布来计算任何潜在数据点的概率值。举个例子,对于一个数据点,比如一张吉娃娃的照片,因为它是一张狗的照片,所以它实际上属于我们的数据分布。因此,这个模型分布通常会为这样的数据点分配较高的概率值。对于一些不相关的数据点,比如一张松饼的照片,因为它不是狗的照片,一个好的模型分布会为这种图片分配较低的概率值。因为这个模型分布提供了一种生成新的数据点的方式,所以我们也将其称为生成模型。
模型提供了一组概率分布族。我们希望通过最小化 $𝑃_𝜃$与 $𝑃_{data}$ 之间的距离,从这个庞大的分布族中找到一个特定的概率分布。之后,我们就可以从 $𝑃_{data}$ 中生成样本。
数据分布可能非常复杂,尤其是当数据维度很高时。因此,我们必须构建一个非常强大的模型分布,才能估计我们的数据分布。那么,如何构建一个强大的模型分布呢?
得分函数:得分函数用于表示我们的概率分布。那么,什么是得分函数呢?假设我们有一个连续的概率分布,使用 𝑝(𝑥) 来表示概率密度函数。我们将得分函数定义为对 log𝑝(𝑥) 的梯度。注意这个梯度是相对于随机变量 𝑥 计算的——它不是相对于任何模型参数(如 𝜃)计算的。
score function:从直觉上来说,分数函数也非常有意义:它告诉你,为了让某个数据点的概率变高,你应该往哪个方向移动它。真实的分数函数可以告诉你,在数据空间中的任意点,你应当往哪个方向移动,才能更接近真实数据点。
得分函数长什么样子呢?我们来看一个简单的例子,即两个高斯分布的混合。这个图展示了这个高斯混合分布的密度函数和得分函数。密度函数用颜色编码,颜色越深表示密度越高。得分函数是一个向量场,给出了密度函数增长最快的方向。给定密度函数,我们可以非常容易地计算得分函数,因为我们只需要对其进行求导。相反,利用得分函数,我们也可以通过计算积分来恢复密度函数。因此它们在理论上是等价的。但是在计算上,与密度函数相比,得分函数要更容易处理。
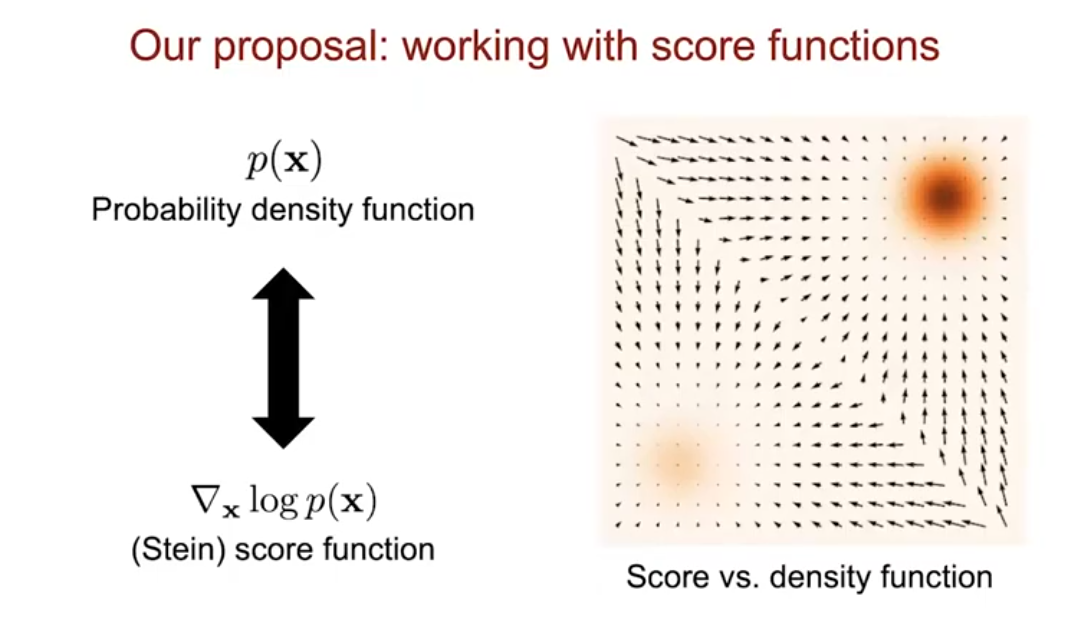
得分模型:根据我们在统计学中的知识,我们知道可以训练一个适当归一化的统计模型,使用如最大似然估计等方法来估计潜在的数据密度。但因为我们想使用得分函数,我们希望开发一个类似的方法,使我们能够训练我们的得分模型来估计潜在的得分函数,且只需一个有限的训练数据集。
从数学角度来看,我们给定一组数据点,假设这些数据点是从数据分布 $P_{\text{data}}$ 中独立采样的。我们的目标是估计数据密度的得分函数。我们给定一个得分模型,这个模型假设是一个深度神经网络模型,能够将高维输入映射到高维输出,并且我们希望训练这个得分模型,使其近似于数据分布的真实得分函数。那么,如何训练这个得分模型,使其接近我们的真实数据得分函数呢?我们需要最小化某个目标函数。这个目标函数必须比较得分函数的两个向量场。这里,一个向量场是数据得分函数的真实值,另一个向量场是由我们的得分模型预测的。我们如何比较它们之间的差异呢?我们回顾一下,这两个向量场实际上位于相同的空间中。因此,我们可能能够计算这些向量对之间的差异向量,然后我们可以对这些差异向量的密度进行积分,形成一个标量值的目标函数。
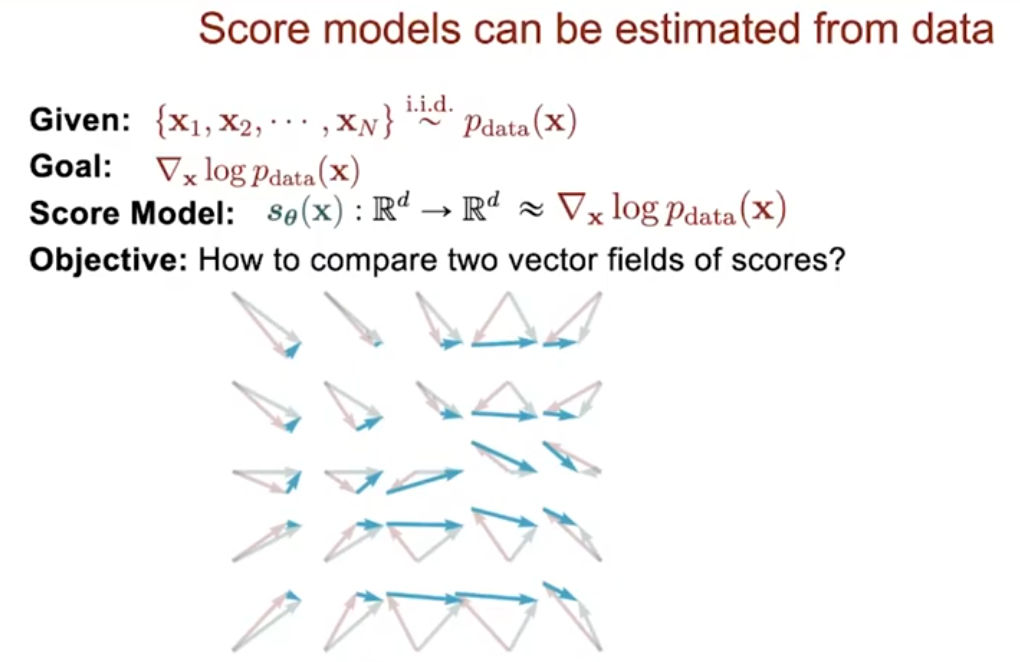 Fisher divergence:
score matching:指的是用我们预测的分数 $𝑠_𝜃(𝑥)$去逼近原始分布的真实分数。这基本上意味着我们试图最小化真实分数和预测分数之间的差异
雅可比矩阵:
切片得分匹配(sliced score matching): 基本的直觉是,一维问题应该比高维问题更容易解决。那么,我们如何将高维问题转换为一维问题呢?我们可以利用随机投影。我们将高维向量场投影到随机方向上。然后我们得到一维标量场。假设这两个高维向量场相互接近。那么我们可以沿着随机的一维方向投影它们。这样,我们就得到了接近的标量场。
denoising score matching:模型在训练时需要从带噪输入中预测负噪声。而预测负噪声的方向恰好是 朝向真实数据分布的方向——这正是“分数”的含义:告诉你朝哪里走概率更大。
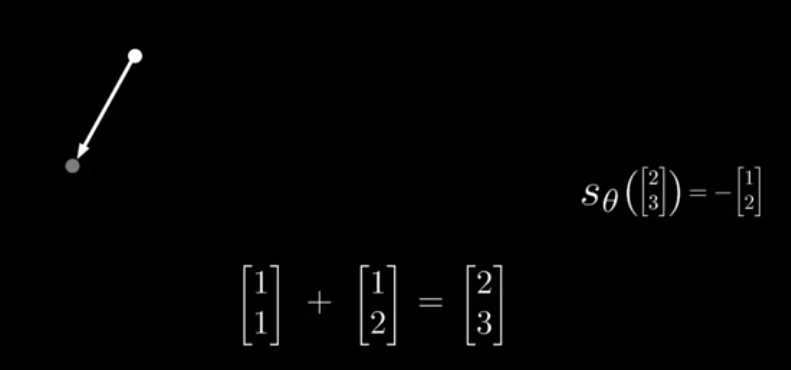 给定一个大的训练数据集,我们可以使用基于原则的统计方法,如得分匹配,来训练我们的得分模型,以估计潜在的得分函数。为了构建我们的生成模型,我们必须找到一种方法,通过得分函数的向量场来生成新的数据点。假设我们已经给定了得分函数。想象一下有许多随机点散布在楼梯上。我们能否通过移动这些随机点来从得分函数中形成样本呢?可以通过跟随得分函数预测的方向来移动这些点。然而,这并不能给我们有效的样本,因为这些点最终会聚集在一起。将高斯噪声注入到得分函数中,并跟随这些噪声扰动的得分函数。
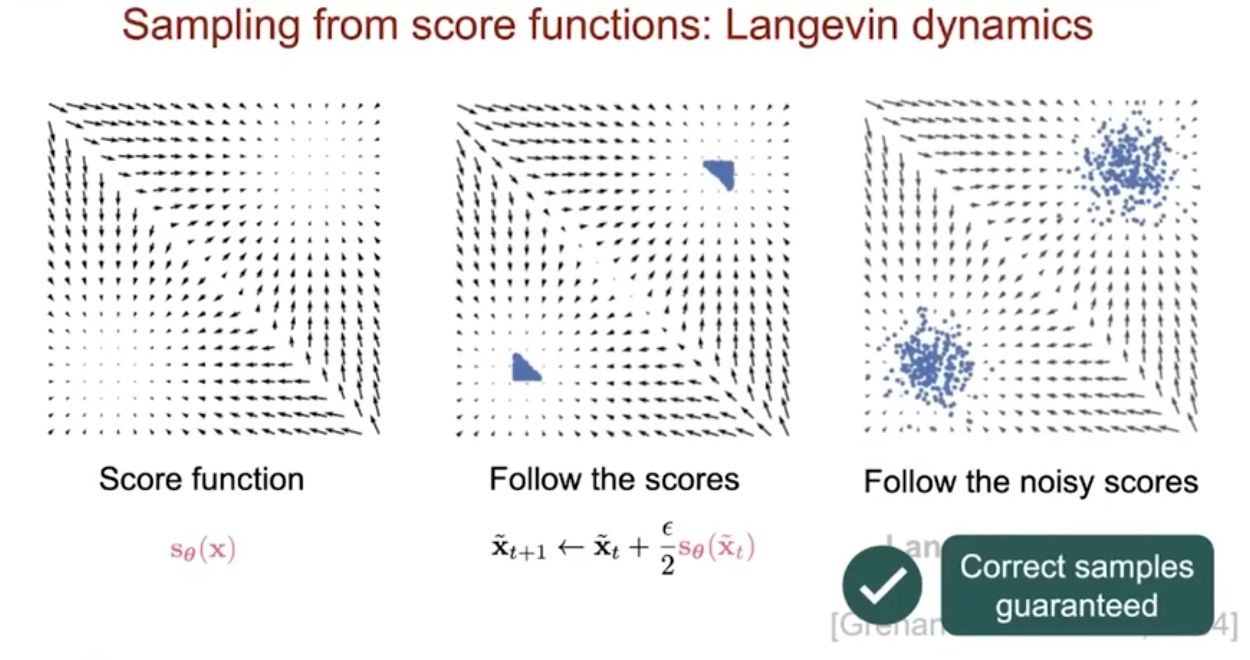
得分匹配可以估计数据的得分函数,Langevin 动力学可以从得分函数中生成样本。所以,用我们的得分模型替换 Langevin 动力学中的得分函数就变得非常自然了,然后我们就可以生成数据样本——从而定义一个新的生成模型。
Langevin 动力学:
score matching can estimate the score function data. And Langevin dynamics can generate samples from the score function. So it becomes very, very natural to just replace the score function in Langevin dynamics with our score model, and then we can generate data samples–we define a new generative model.
Noise Perturbation:为数据加上不同程度的噪声,让数据分布更多的空间。
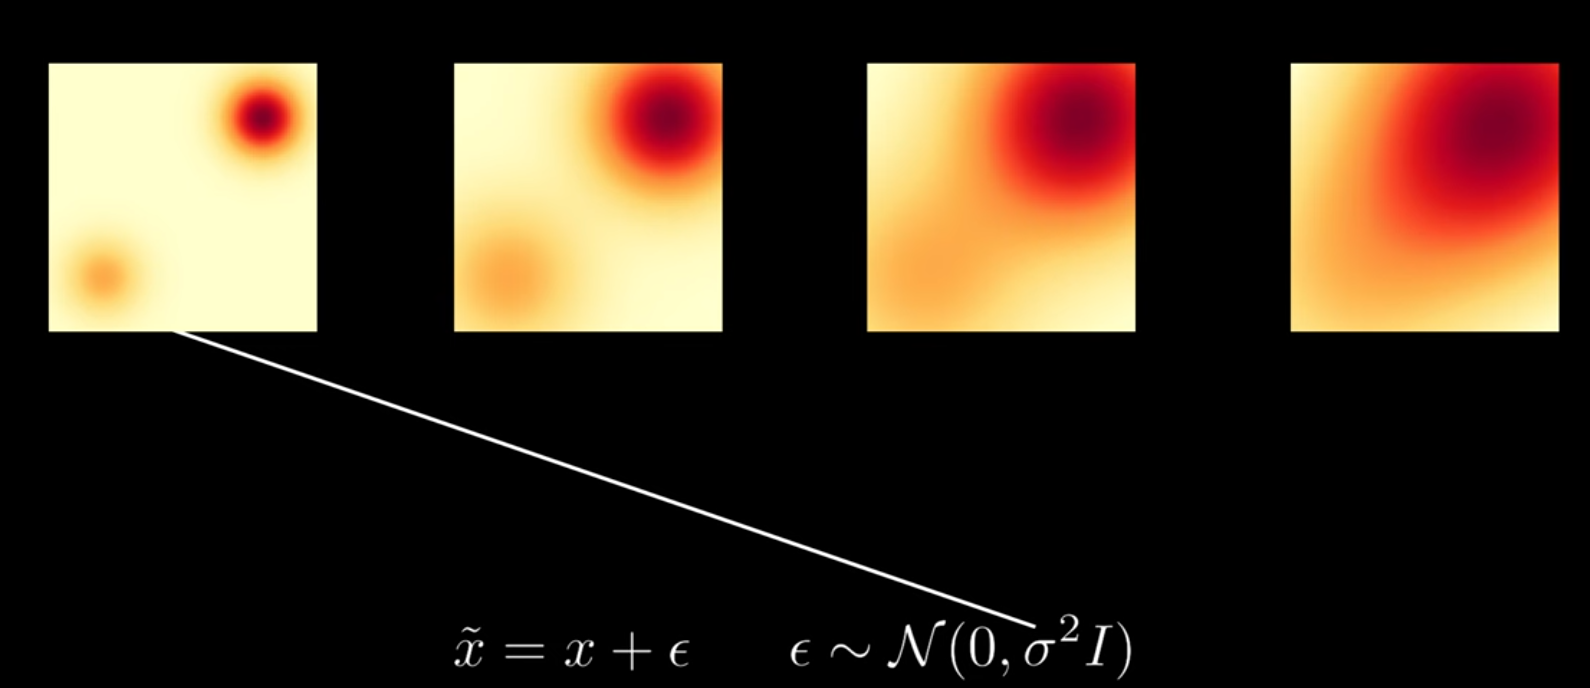
Multiple Noise Perturbations:面临一个权衡问题:添加大噪声虽然能覆盖更多的数据空间,但也会改变数据的分布。如果我们选择一个非常低的 𝜎,那么当我们计算 $\tilde{x}$时,噪声 𝜖 的标准差会非常小,显然它只包含非常小的值。可以做两者,或者说介于两者之间。我们可以在高噪声、中等噪声和低噪声水平下训练模型。简单地在一个预定义的范围内变化 𝜎,比如从 0.01 到 25 之间。这样,模型就能看到数据空间中的各个区域。根据噪声水平来调节模型,这是额外的自由信息,可能有助于模型在预测分数时做得更好。唯一的变化是 𝜎 的索引,这意味着它不再是一个固定的单一值,而是不同噪声值的序列,包括低噪声和高噪声。模型会在高 𝜎 时看到数据空间的大部分区域,但在 𝜎 小时也能看到清晰的数据分布。这样,我们就能同时获得两者的优点。
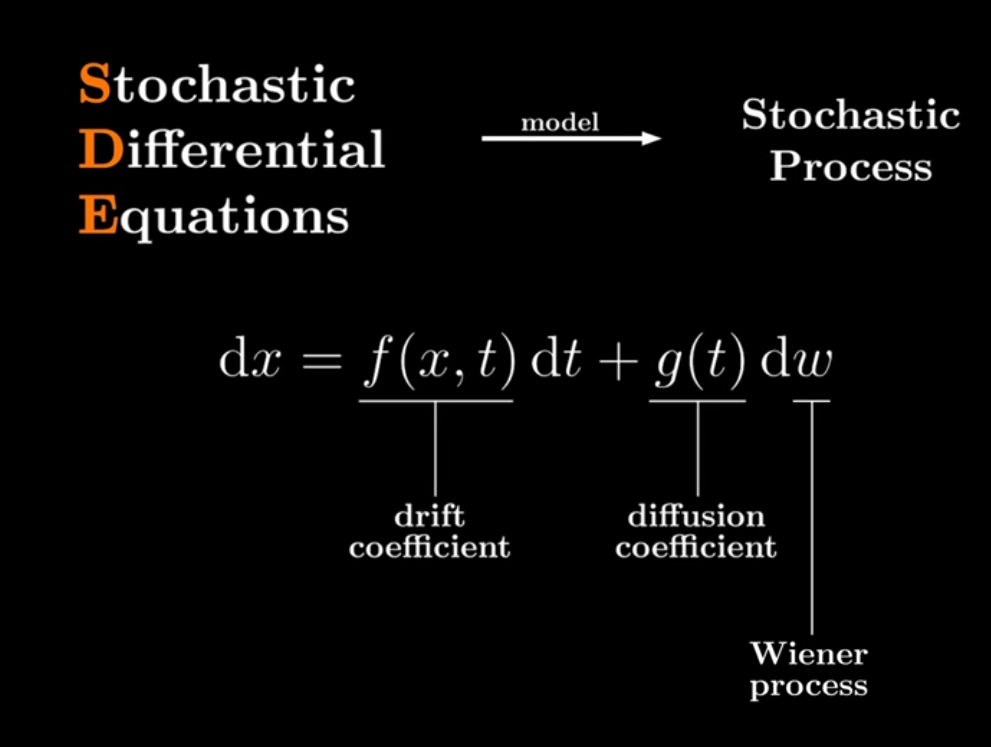
当你将噪声水平的数量增加到无限大时,噪声扰动变成了一个随机过程。使用一个高级的术语——随机微分方程(SDE) 来建模这些随机过程。
噪声数据密度的得分函数更容易准确估计,而且这些噪声数据密度的得分函数可能为指导 Langevin 动力学从低数据密度区域移动到高数据密度区域提供有价值的方向信息。但单纯地注入高斯噪声并不能解决所有问题。由于数据点的扰动,这些噪声数据密度不再是对原始真实数据密度的良好近似。
使用不同噪声水平的多重序列。使用均值为 0,标准差从 $𝜎_1$ 到 $𝜎_3$ 的高斯噪声来扰动我们的训练数据集。这将给我们三个带噪声的训练数据集。对于每个带噪声的数据集,将有一个相应的噪声数据密度,我们用 $𝑝_{𝜎_1}$ 到 $𝑝_{𝜎3}$ 来表示。我们希望估计对应噪声密度的潜在函数。如何估计三个带噪声的得分函数呢?最直观的方法是我们训练三个网络,每个网络负责估计单一噪声水平的得分函数。一个更具可扩展性的解决方案是考虑一个条件得分模型,我们称之为噪声条件得分模型。将噪声水平 𝜎 作为一个额外的输入维度加入到模型中。输出对应于扰动了噪声水平 𝜎 的数据密度的得分函数。我们有一个得分匹配损失的求和项。对于每个噪声水平 $𝜎_𝑖$,我们有一个得分匹配损失,并且我们有一个正的加权函数 $𝜆𝜎_𝑖$。得分模型与扩散模型之间的联系首次在 2020 年的 DDPM 论文中揭示。回到如何在训练了得分匹配损失后从噪声条件得分模型中采样的问题。仍然可以使用 Langevin 动力学。首先应用 Langevin 动力学从最大的扰动噪声的得分模型中进行采样。这些样本将作为初始化,接着从下一个噪声水平的得分模型中进行采样。以这种方式继续,直到最终从具有最小噪声水平的得分函数中生成样本。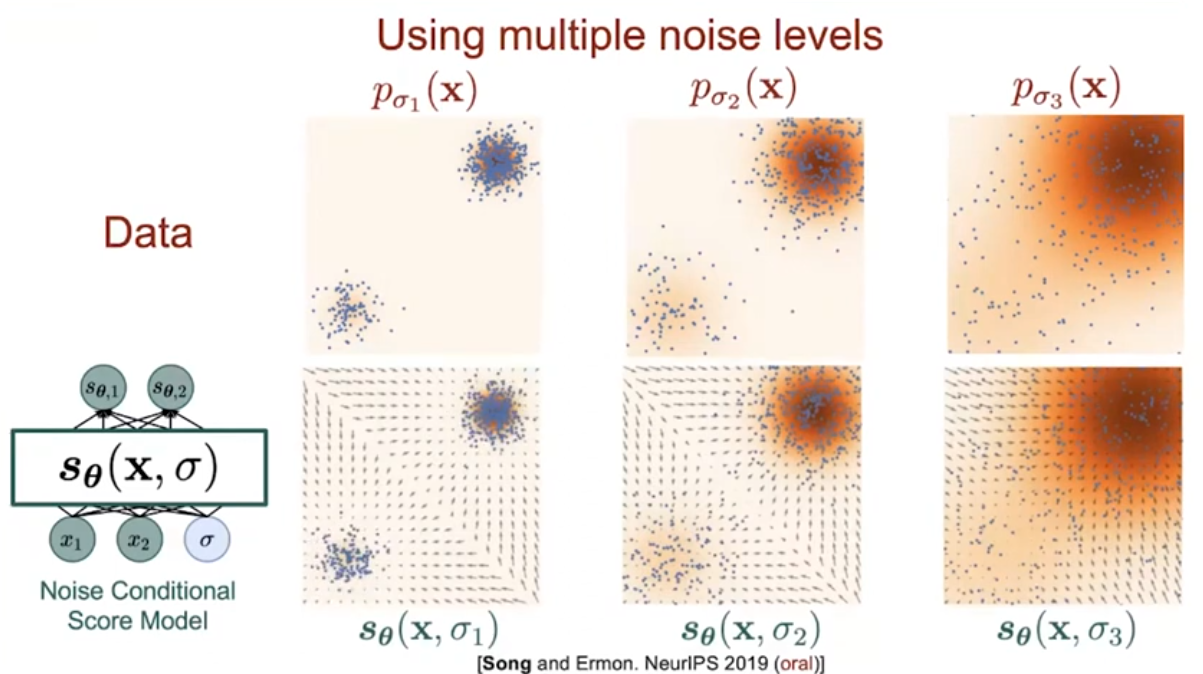
假设我们有一个无条件(unconditional)的 score-based 生成模型,它能够同时生成狗和猫的图像。但现在我们只想生成狗的图像。那么该怎么做呢?我们假设有一个前向模型(forward model),它是一个图像分类器:给定图片 x 输出其标签 y。 我们希望使用一个控制信号,即目标标签 y,并将其指定为“狗”。目标是从条件分布 p(x∣y)p(x|y)p(x∣y) 中采样。 这个条件分布就只会产生狗的图像。我们将其称为逆分布(inverse distribution),因为它可以被视为前向模型的概率反演。那么我们如何获得这个逆分布呢? 常见方法是使用 Bayes 定理。其中我们已知无条件分布 𝑝(𝑥),前向模型提供 𝑝(𝑦∣𝑥),但分母 𝑝(𝑦) 是一个归一化常数,难以直接求出。这个问题可以通过 score 函数 来规避。我们只需要对 Bayes 定理两边取对数,然后再对 𝑥 求梯度。由于归一化常数与 𝑥 无关,其梯度为零,从而消失。 也就是说,条件分布的 score 函数是两个部分的和:
- 无条件 score 函数(可以通过训练好的无条件 score 模型获得)
- 前向模型对数概率的梯度(例如分类器梯度,可直接反向传播求得)
其好处是:
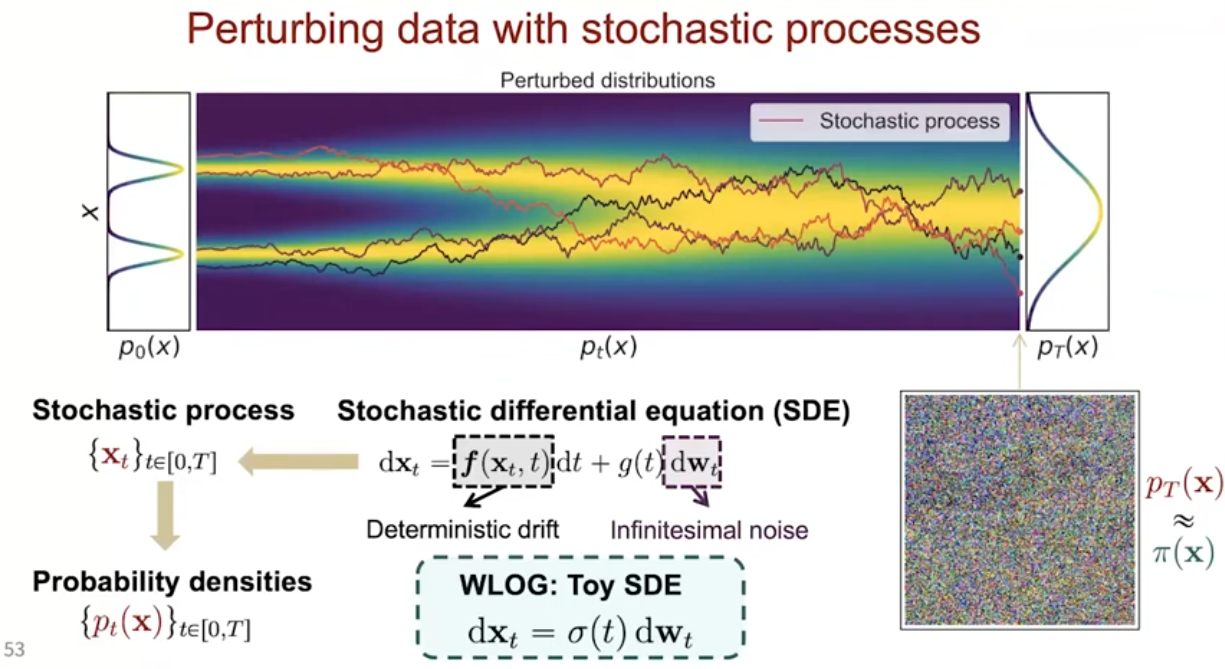
我们 只需要训练一次无条件模型,然后通过改变前向模型,就能实现多种条件生成应用。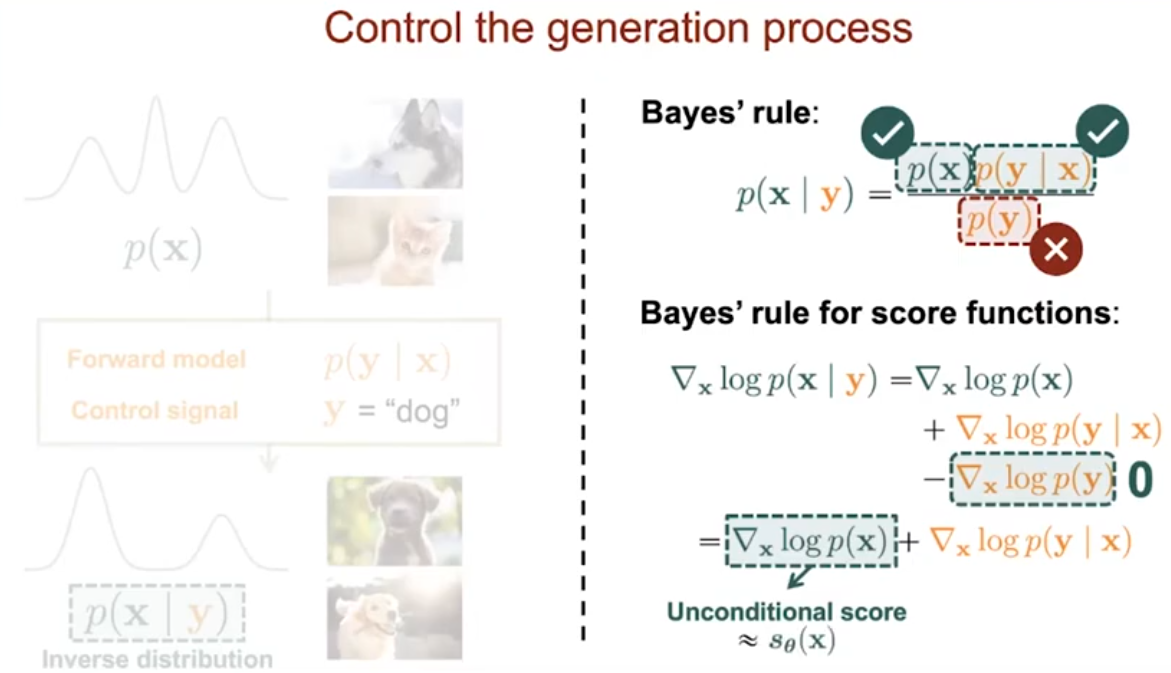 stochastic process:从原始的干净数据点开始,逐渐注入高斯噪声,使数据不断被扰动。随着噪声注入的不断累积,最终我们会得到非常嘈杂的图像,它们接近于来自某个简单高斯分布的样本。这些带噪声的数据在噪声注入过程中所形成的轨迹,就是一个随机过程的轨迹。
一个随机过程可以理解为:由无限多个随机变量组成的集合,而这些随机变量由一个连续参数 ttt 进行索引。对于每一个随机变量,都会对应一个概率密度分布。因此,一个随机过程就对应了无限多个概率密度函数。
那么,我们如何选择一个合适的随机过程,使它能够表示这无限多个带噪声的数据分布呢?
答案是引入随机微分方程(Stochastic Differential Equation, SDE)。
随机微分方程与普通微分方程非常相似,但它多了一个用来引入随机性(噪声)的项。
 reverse stochastic process:
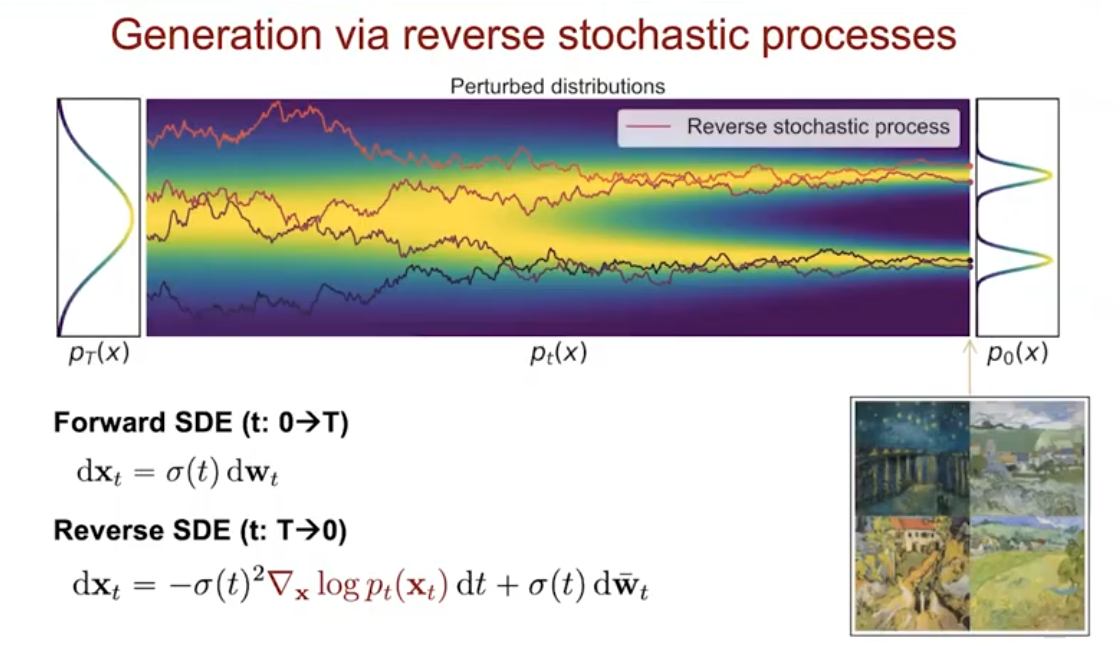
Euler-Maruyama approach:
KL divergence:
前向模型(forward model)与score 函数之间的联系。比如你说前向模型可以是物理模拟、也可以是图像转文本网络。那么前向模型有什么要求?它的限制是什么? 理想情况下,前向模型和 score 函数一样,也需要依赖噪声水平 𝑡。 如果前向模型能够根据噪声水平进行条件化,那么我们就能直接、严格地从条件分布中采样,例如文本到图像生成就是这样实现的——这些模型中的前向模型都是随时间(噪声水平)变化的。如果前向模型不依赖噪声水平,就像医疗图像重建中的情况,我们就需要做近似。 如果前向模型是线性的,近似通常比较容易,并且现在已经有一系列工作提供了有效的近似方法。 如果前向模型是非线性的,问题会更复杂一些,但仍然是可行的,也有相关研究。目前仍然有一个研究方向在探索: 是否存在一种有原则的方法,可以将一个单一的前向模型转换为一系列依赖噪声水平 𝑡 的前向模型。
probability density function:PDF is all you need to sample from a distribution。概率密度函数。告诉我们。我们需要的数据(如猫的图片,狗的图片)在空间中的位置。